관제 영역을 제어 영역과 나눈 이유
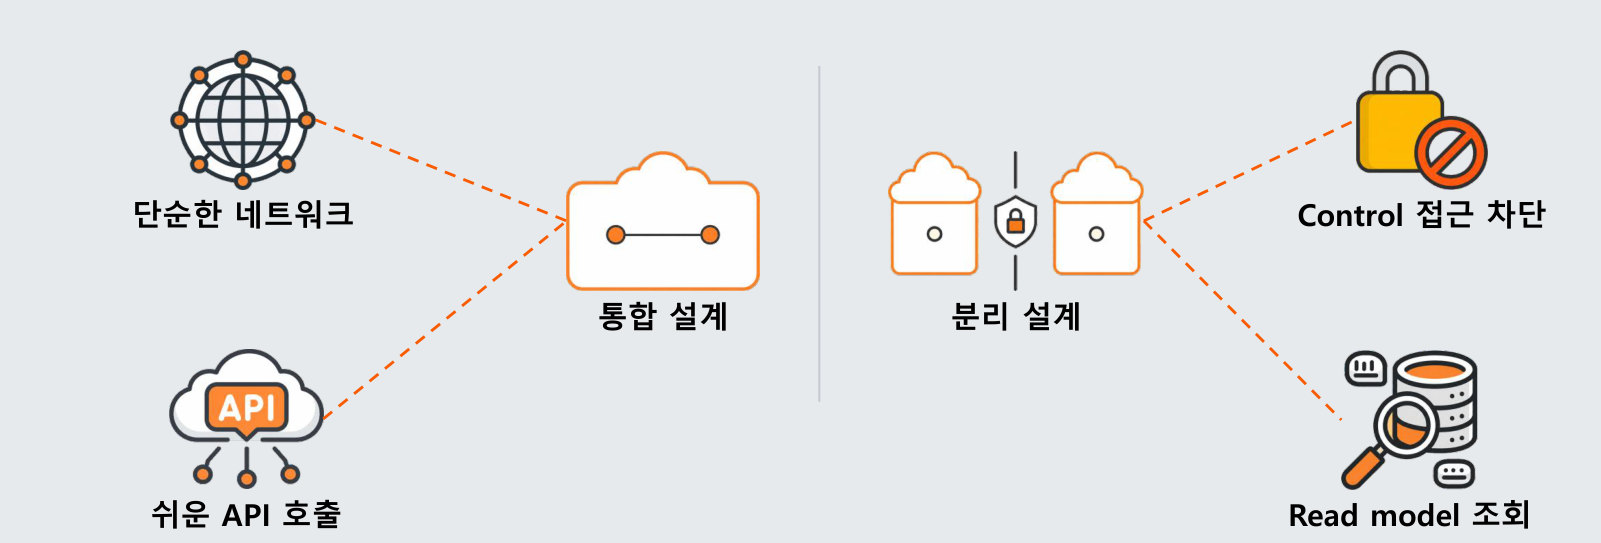
관제 화면이 관리 VPC의 EKS와 Argo CD를 직접 부르면 네트워크와 API 호출은 단순합니다. 하지만 화면이 제어 기능에 닿을 수 있고 장애 범위도 겹칩니다. 그래서 두 영역을 네트워크로 잇지 않고 DynamoDB와 S3에 저장된 결과만 조회하게 했습니다. 대신 제어 영역을 바로 조회하는 편의는 포기했고, 화면에 필요한 값은 팀원과 정한 형식으로 먼저 저장돼야 합니다.
설계와 검증 근거 보기 ↗AWS 관제 플랫폼 | MSP 최종 팀 프로젝트 | 2026.05 - 2026.06
여러 공장의 안전 상태를 한 화면에서 보는 AWS 관제 플랫폼
2인 팀에서 데이터/대시보드 인프라와 관제 화면을 맡았습니다. 이력 조회 504를 막은 임시 조치가 위험 신호를 가린다는 것을 발견하고, 조회 구조를 다시 설계했습니다.
해결한 문제
이력 조회 504
기간별로 읽는 데이터를 나눠 위험 신호 복원
확인
테스트 38개
모의 AWS 환경에서 다시 실행해 통과
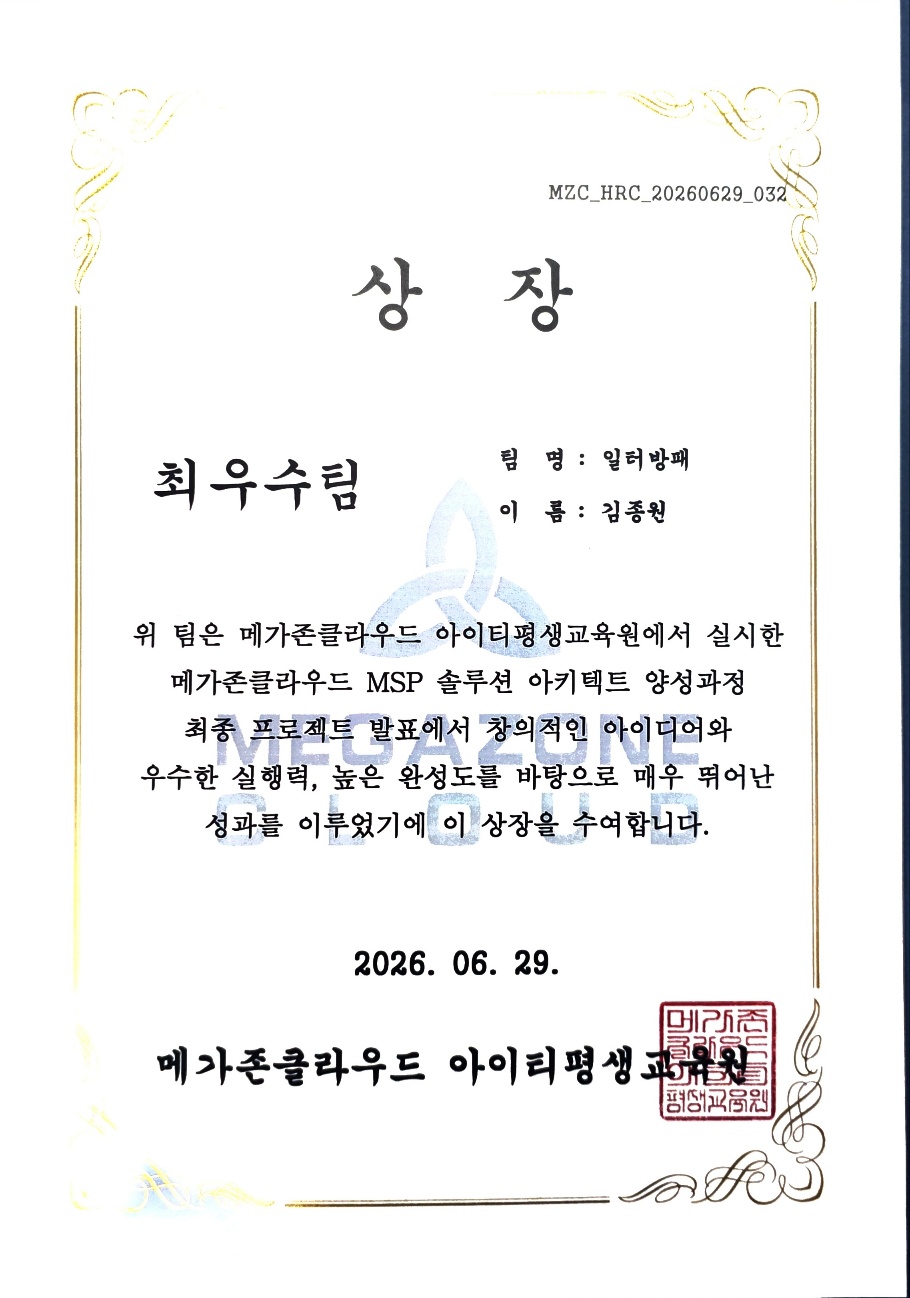
수상
최우수팀
MSP 최종 프로젝트 발표 (팀 수상)
문제 해결 과정
응답만 돌아오게 만든 조치가 관제 화면의 목적을 해치고 있었고, 조회 구조를 다시 나눠 해결했습니다.
1문제
3개 공장의 24시간 이력을 함께 열면, 3초마다 쌓이는 이력을 한꺼번에 읽느라 백엔드의 동시 조회 한도가 가득 차 504가 연달아 났습니다.
2임시 조치
제가 한 번에 읽는 양을 최신 500건으로 줄이자 504 없이 응답이 돌아왔습니다.
3새 문제
500건은 1시간 이력도 다 담지 못했습니다. 앞서 점수가 급락했다가 회복된 구간이 차트에서 빠져, 지나간 위험을 확인하는 이력 화면의 목적을 채우지 못했습니다.
4해결
팀원과 방식을 정해 1시간은 원본(최대 2,000건, 새 데이터만 이어 받기), 6, 12, 24시간은 팀원이 만든 5분 집계를 읽게 했습니다. 평균과 최솟값을 함께 표시해 급락이 평균에 묻히지 않게 했고, 회귀 테스트로 확인했습니다.
설계 배경
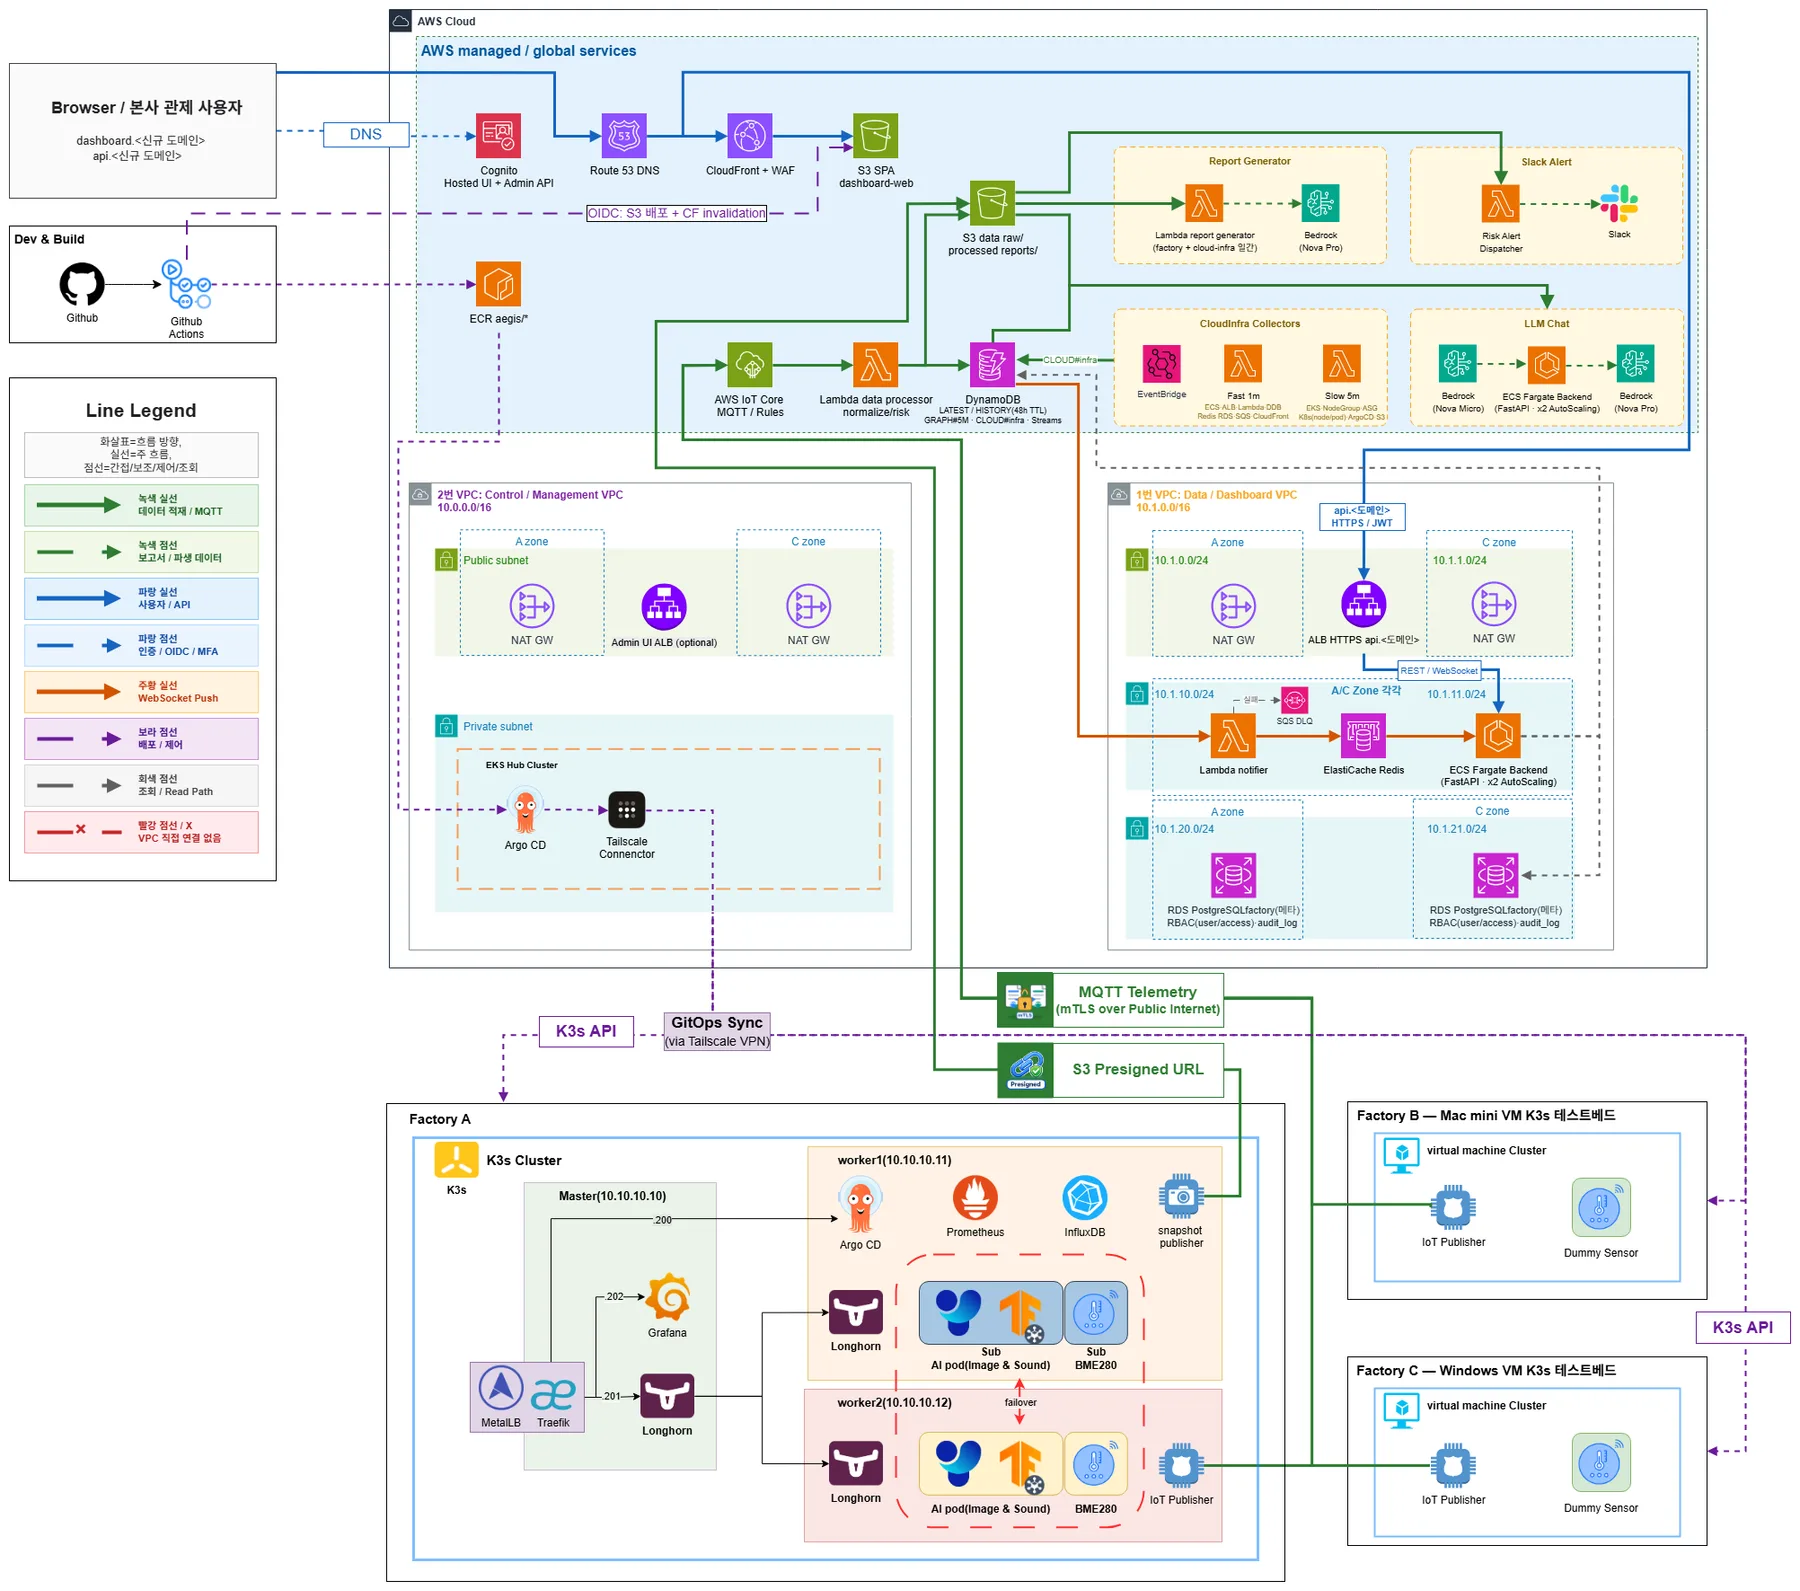
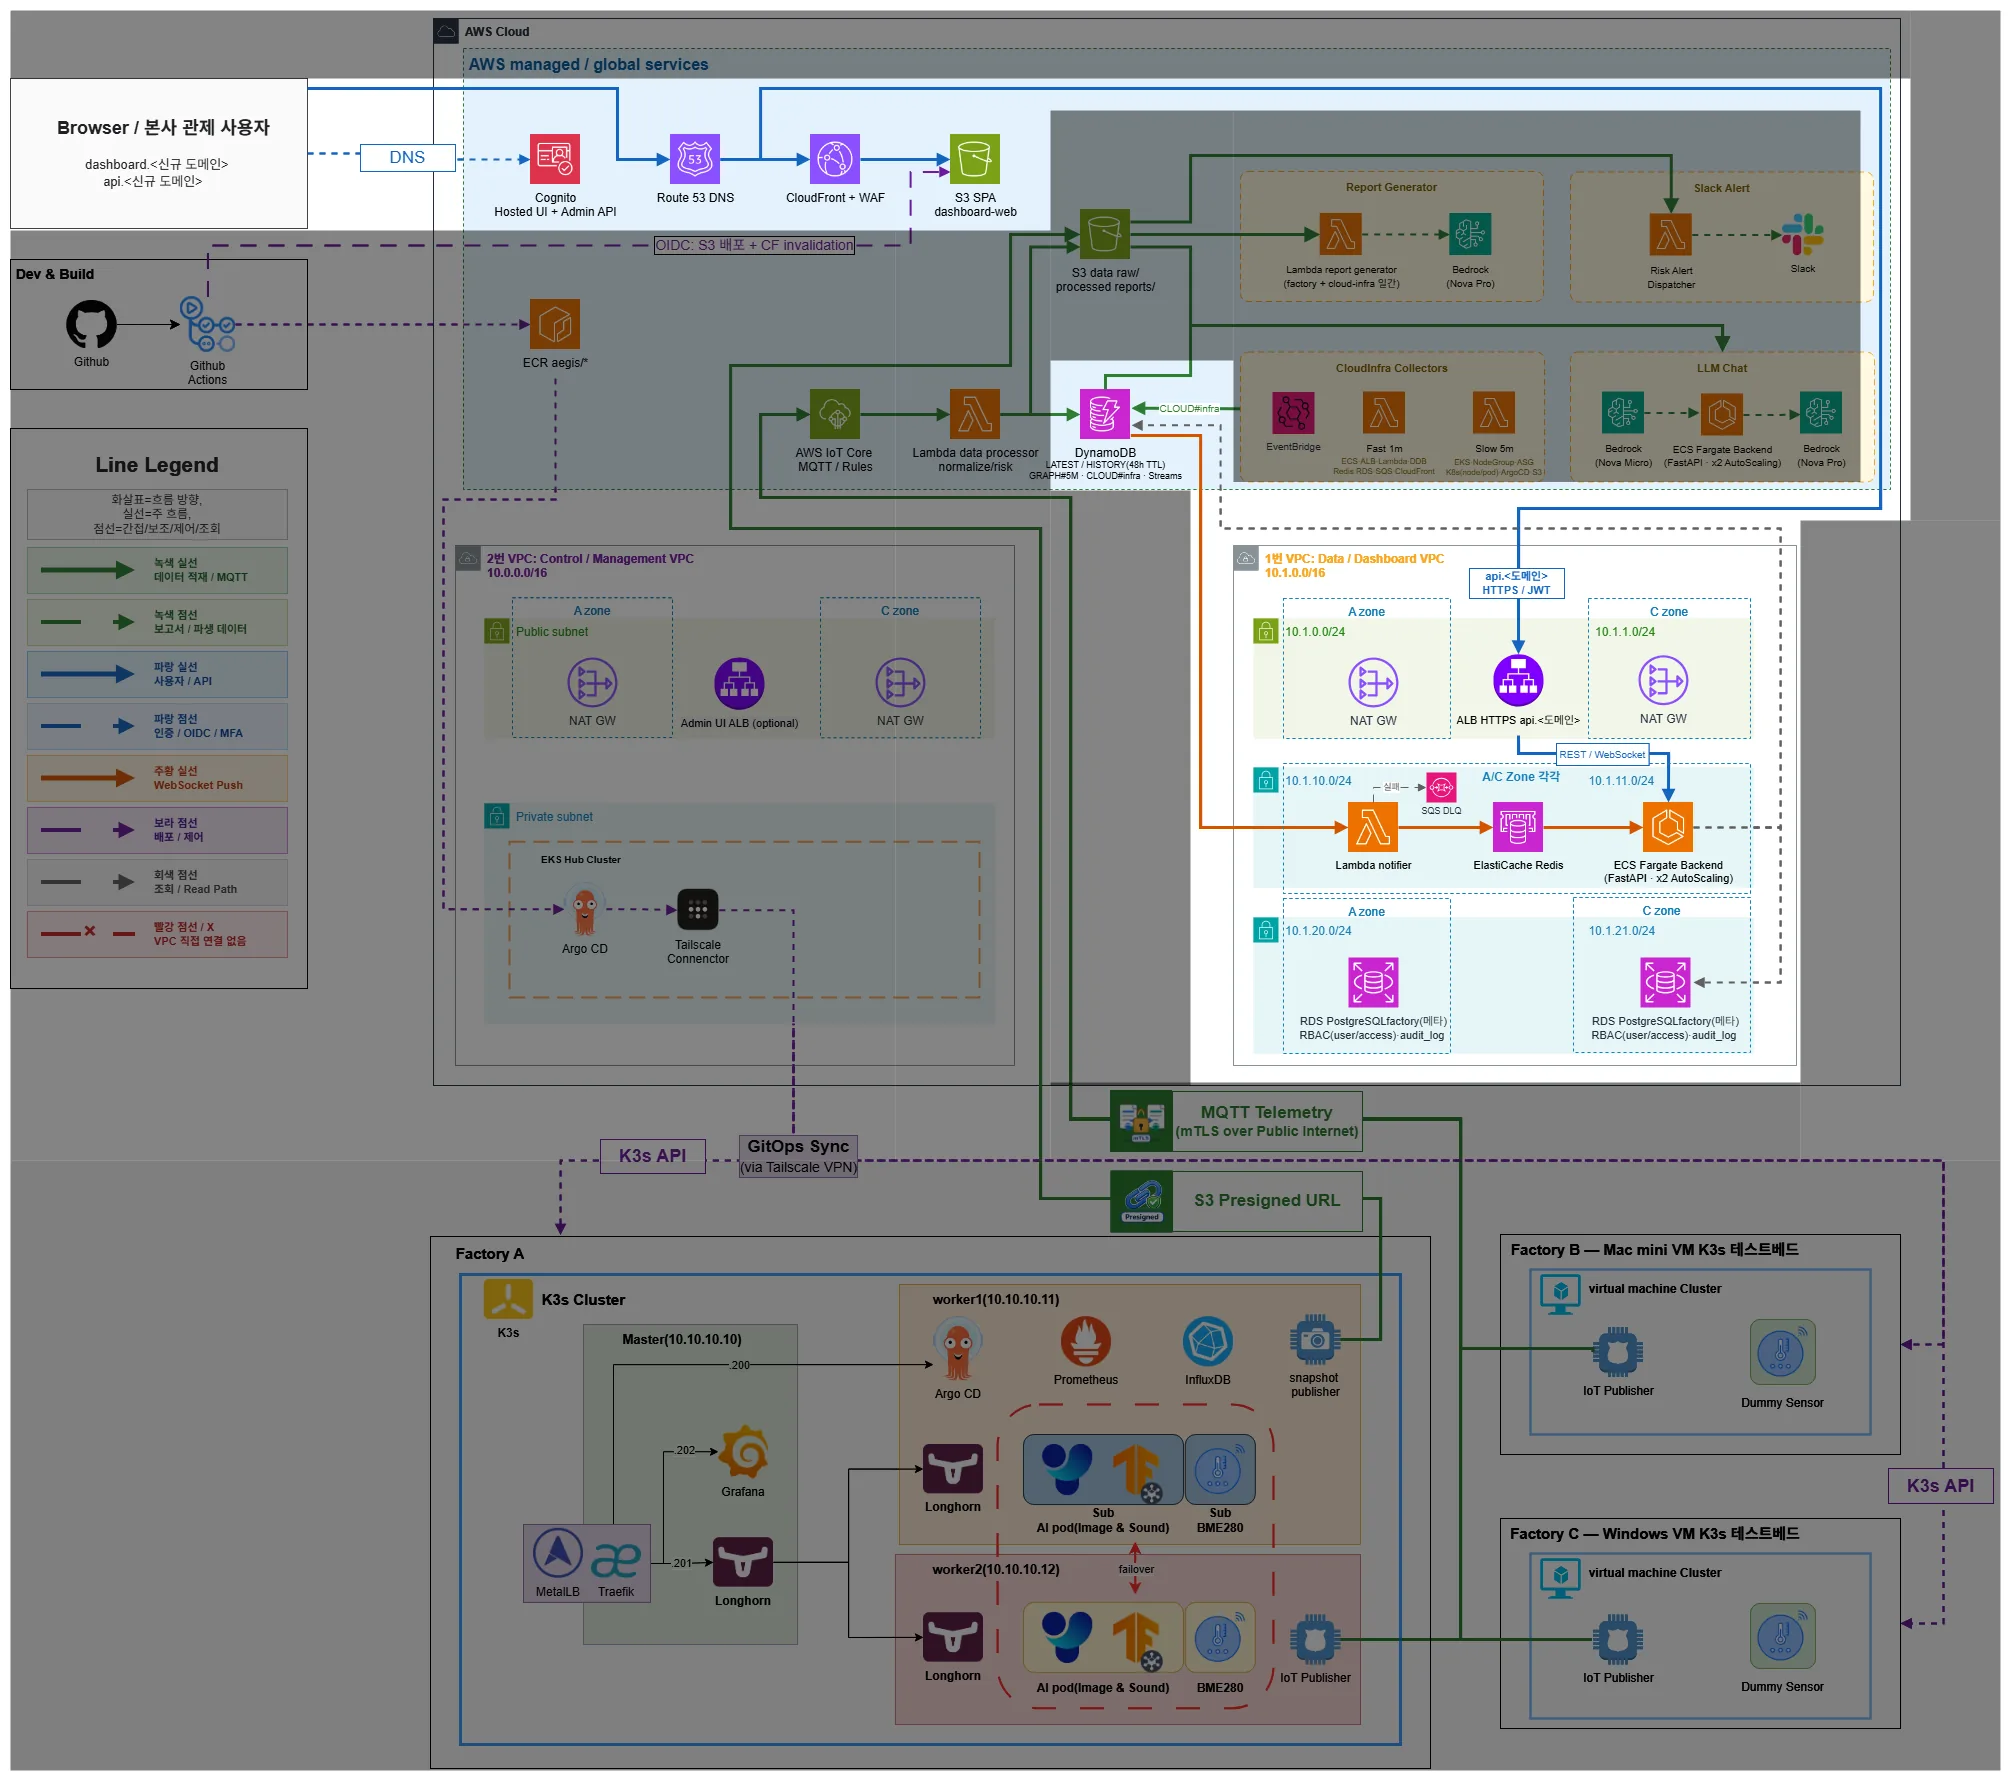
여러 공장의 상태를 중앙에서 같은 기준으로 봐야 했습니다. 관리용 경로와 사용자 조회 경로가 섞이면 대시보드 장애가 운영 도구까지 번질 수 있어 두 경로를 VPC 단위로 나눴습니다.
데이터 흐름
공장에서 보낸 데이터가 AWS를 거쳐 대시보드와 AI 리포트, 알림까지 가는 경로입니다.
관리 영역과 대시보드 영역을 VPC로 나눠, 대시보드가 관리 도구를 직접 호출하지 않게 했습니다.
현장
공장 엣지 (K3s)
센서, AI 상태 데이터 생성
클라우드
AWS 수집, 조회
IoT Core → Lambda → DynamoDB
AI 활용
리포트, 알림
Bedrock 리포트, 대화, Slack 알림
관리 영역 (팀)
EKS, Argo CD: 공장 배포와 운영 도구
대시보드 영역 (직접 구현)
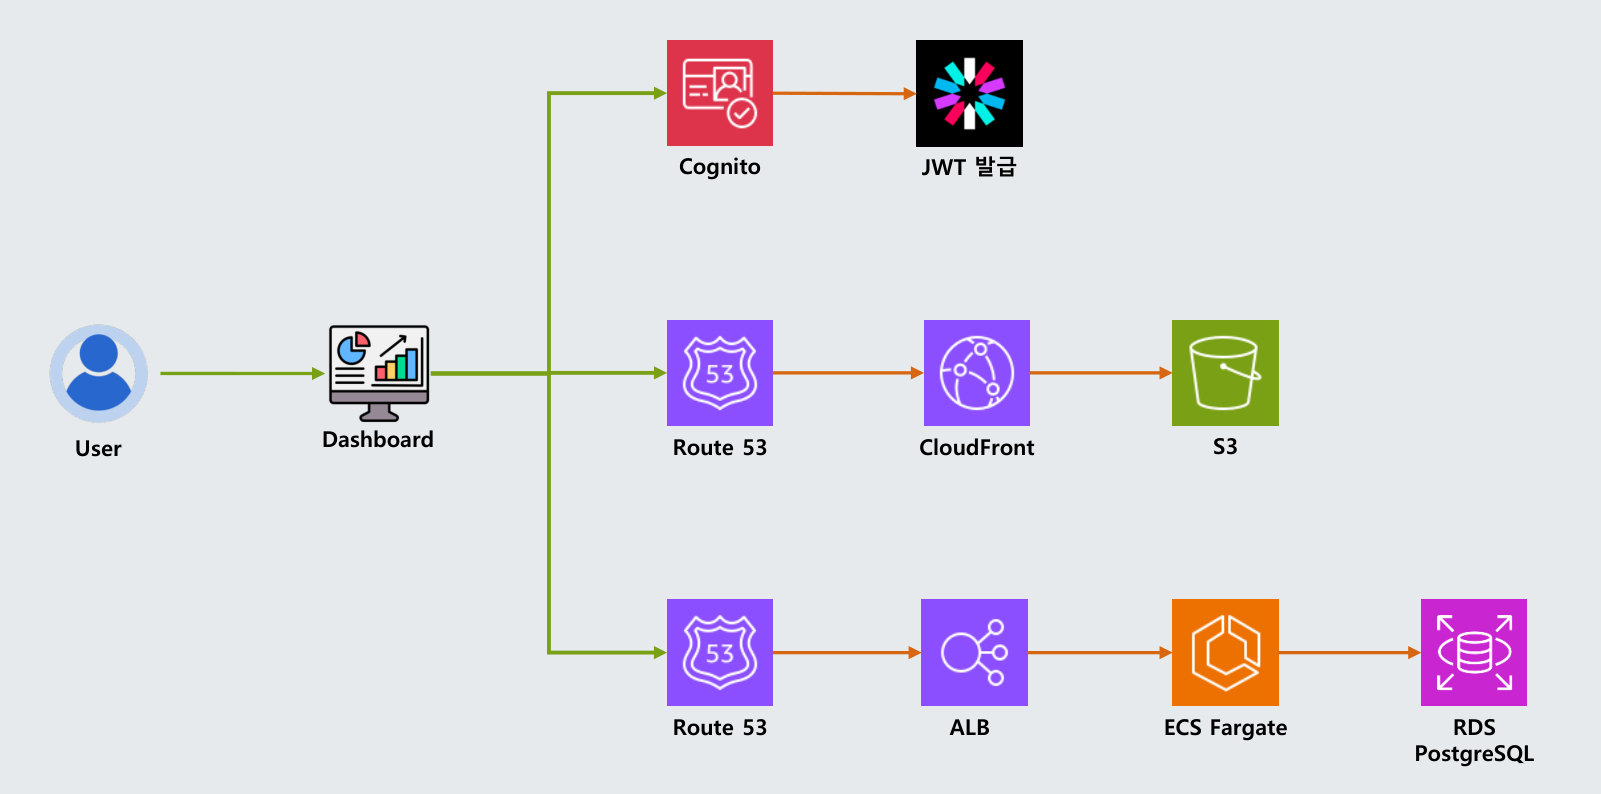
CloudFront, ECS Fargate FastAPI, React
대시보드 영역에 함께 둔 구성
판단 과정
관제 화면이 관리 VPC의 EKS와 Argo CD를 직접 부르면 네트워크와 API 호출은 단순합니다. 하지만 화면이 제어 기능에 닿을 수 있고 장애 범위도 겹칩니다. 그래서 두 영역을 네트워크로 잇지 않고 DynamoDB와 S3에 저장된 결과만 조회하게 했습니다. 대신 제어 영역을 바로 조회하는 편의는 포기했고, 화면에 필요한 값은 팀원과 정한 형식으로 먼저 저장돼야 합니다.
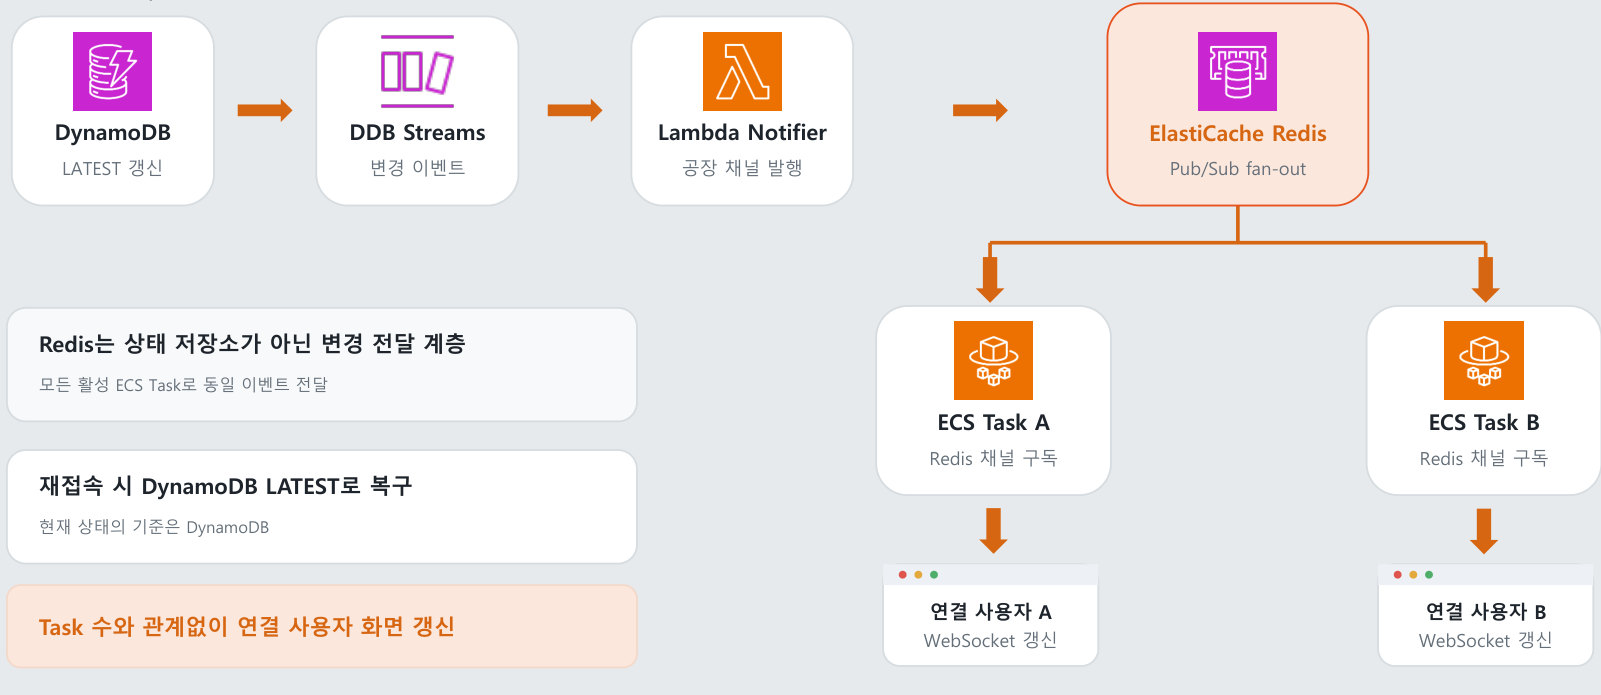
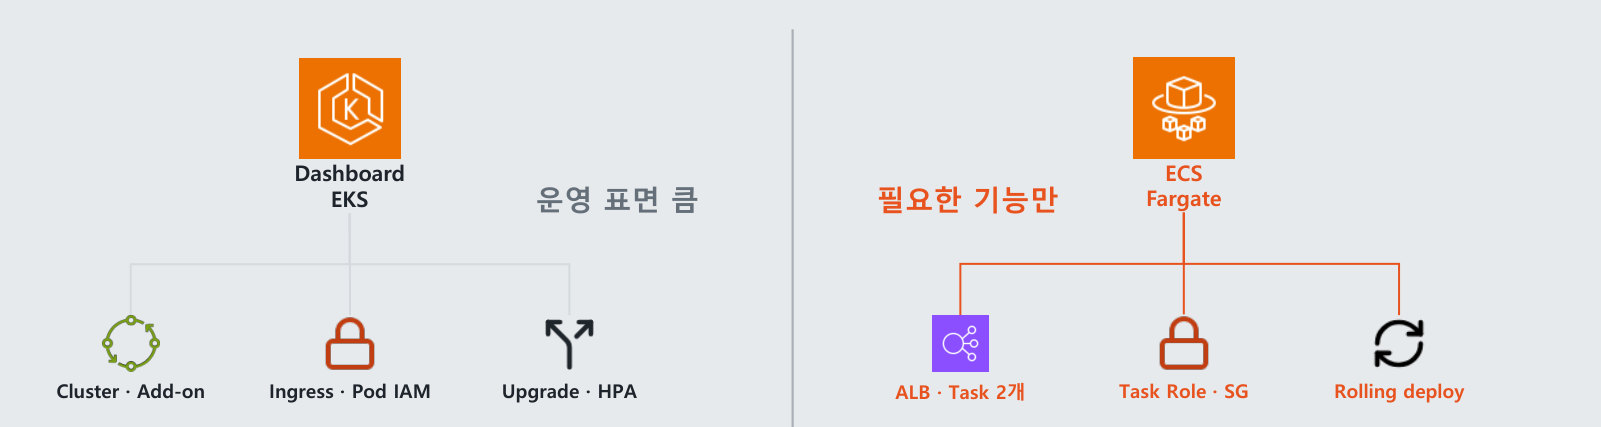
설계와 검증 근거 보기 ↗WebSocket 연결을 유지하고 DB와 Redis 연결을 재사용하려면 항상 떠 있는 서버가 필요해 Lambda는 맞지 않았습니다. 관제 API는 FastAPI 서비스 하나라서, 대시보드용 EKS를 따로 두면 클러스터와 애드온, Ingress, Pod IAM, 업그레이드까지 챙겨야 합니다. ECS Fargate에서는 ALB, Task 2개, Task Role과 보안 그룹, 롤링 배포만 관리했습니다. 대신 상시 실행 비용이 들고, 단일 AZ NAT 구성은 보완 과제로 남겼습니다.
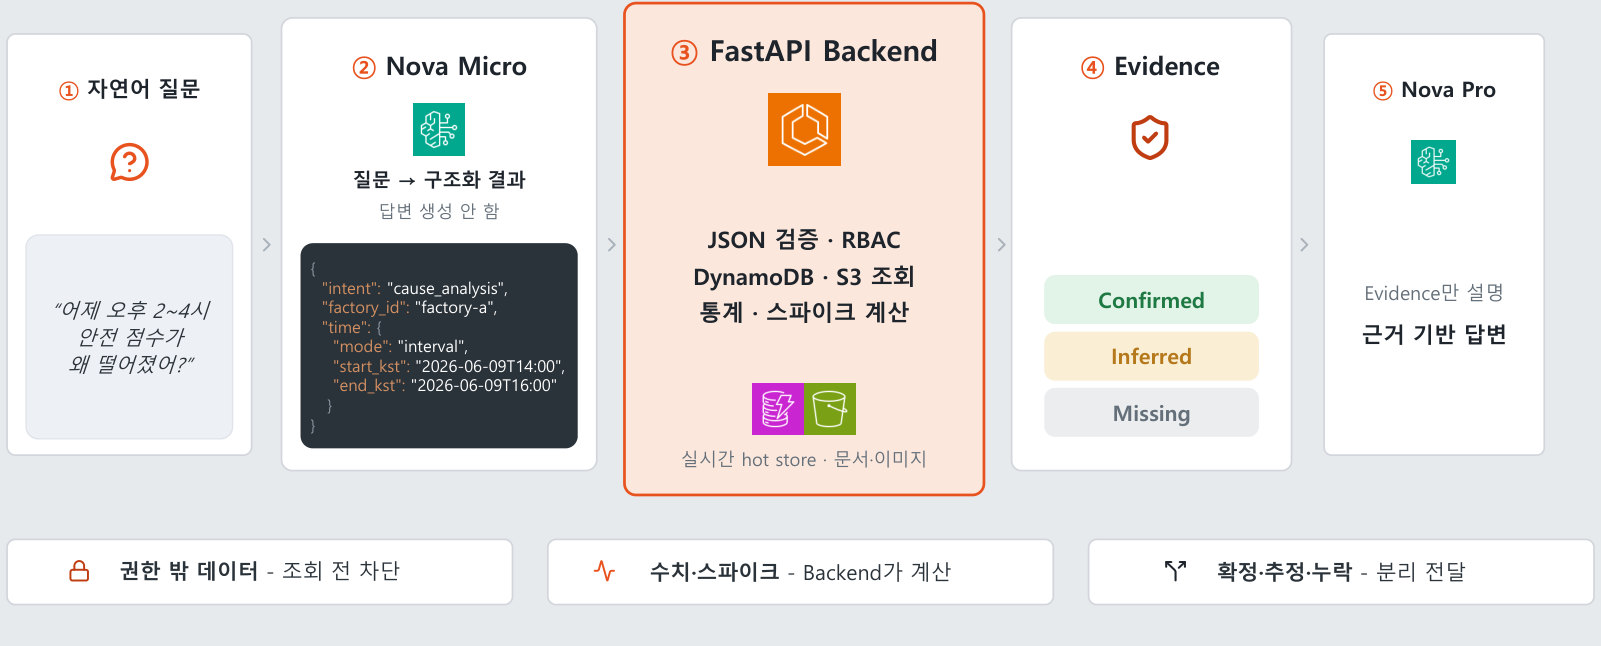
설계와 검증 근거 보기 ↗안전 점수는 낮을수록 위험합니다. 5분 단위로 평균만 내면 짧은 급락이 묻히기 때문에 최솟값을 함께 저장했고, 데이터가 없는 구간을 0점으로 계산하지 않는지 테스트로 확인했습니다.
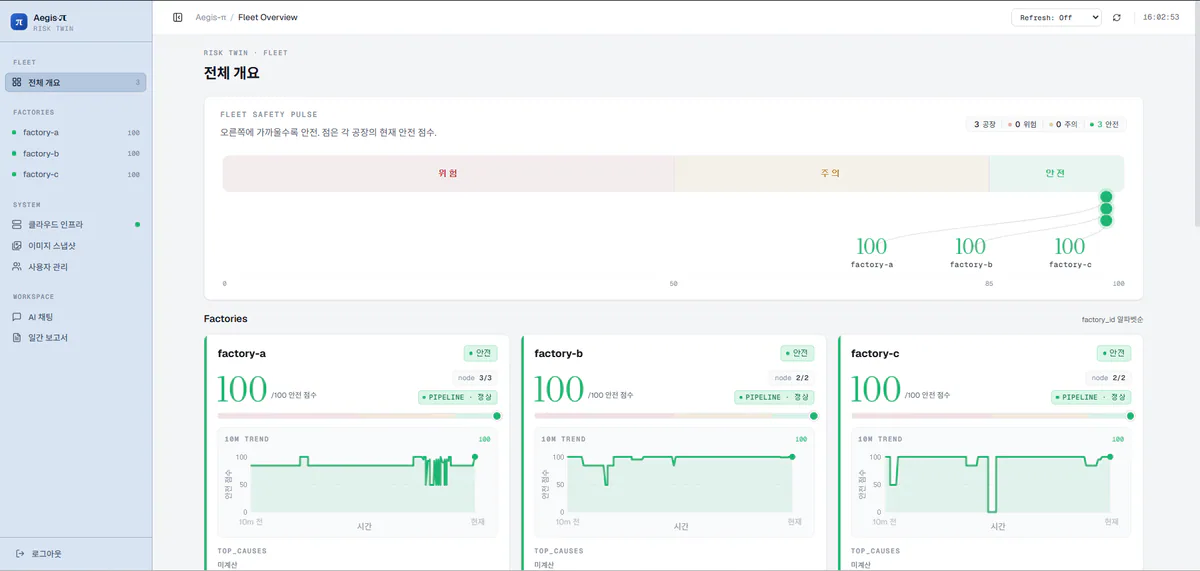
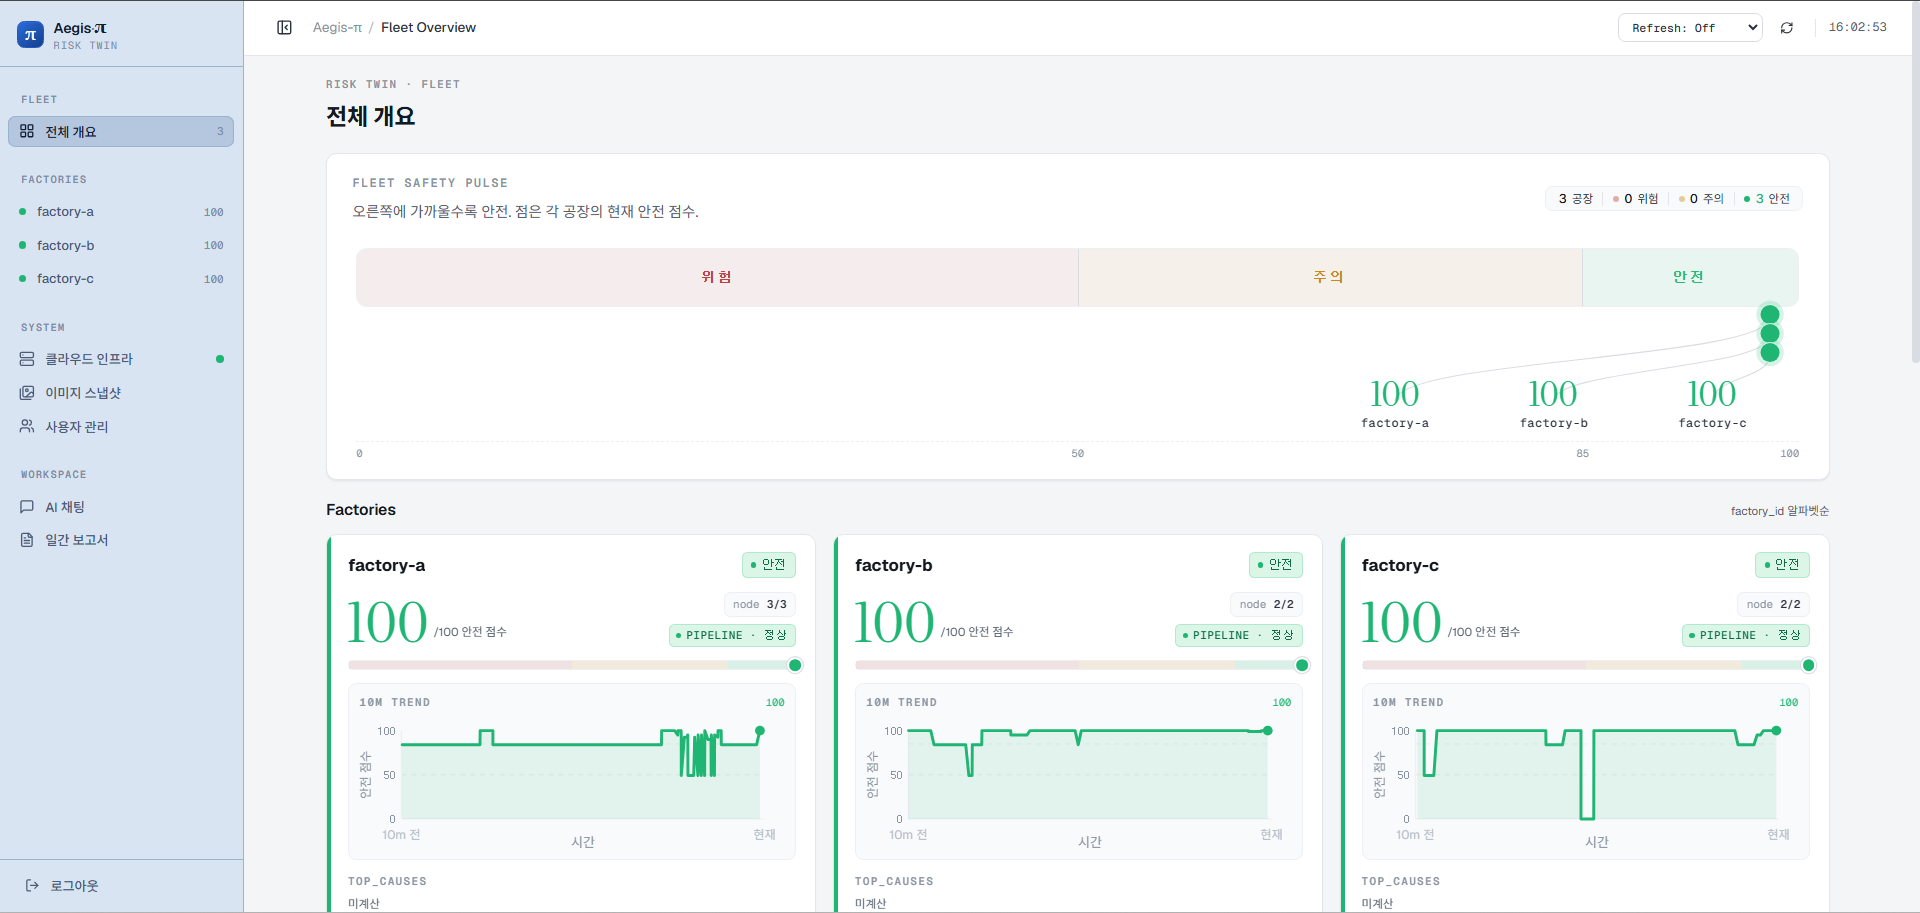
설계와 검증 근거 보기 ↗실제 화면
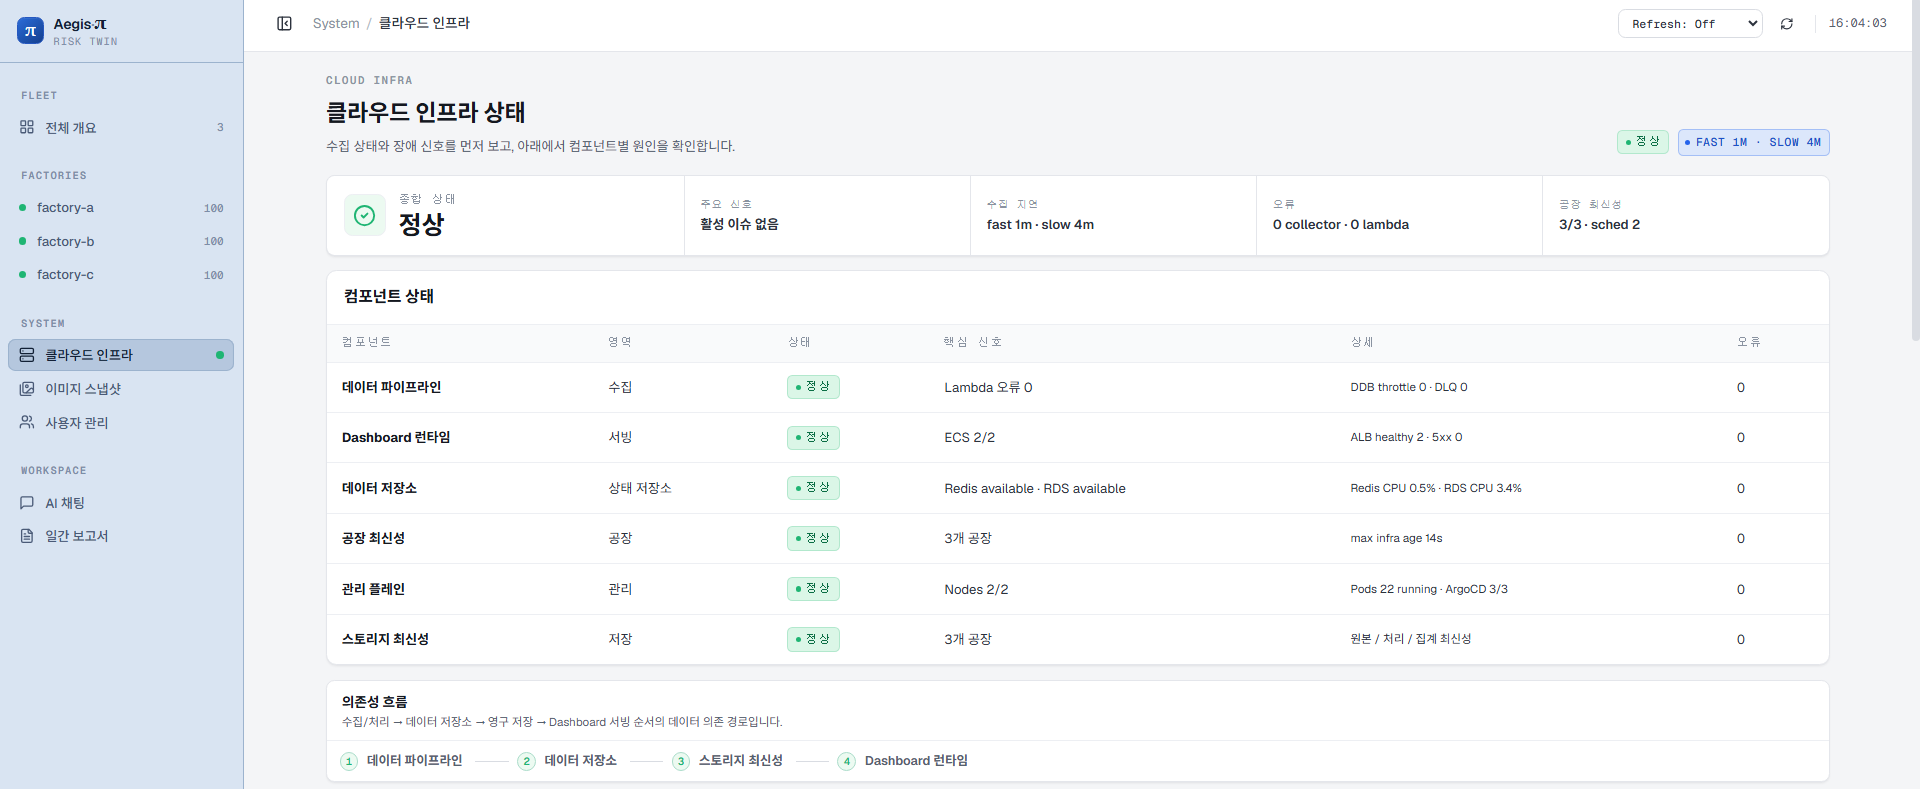
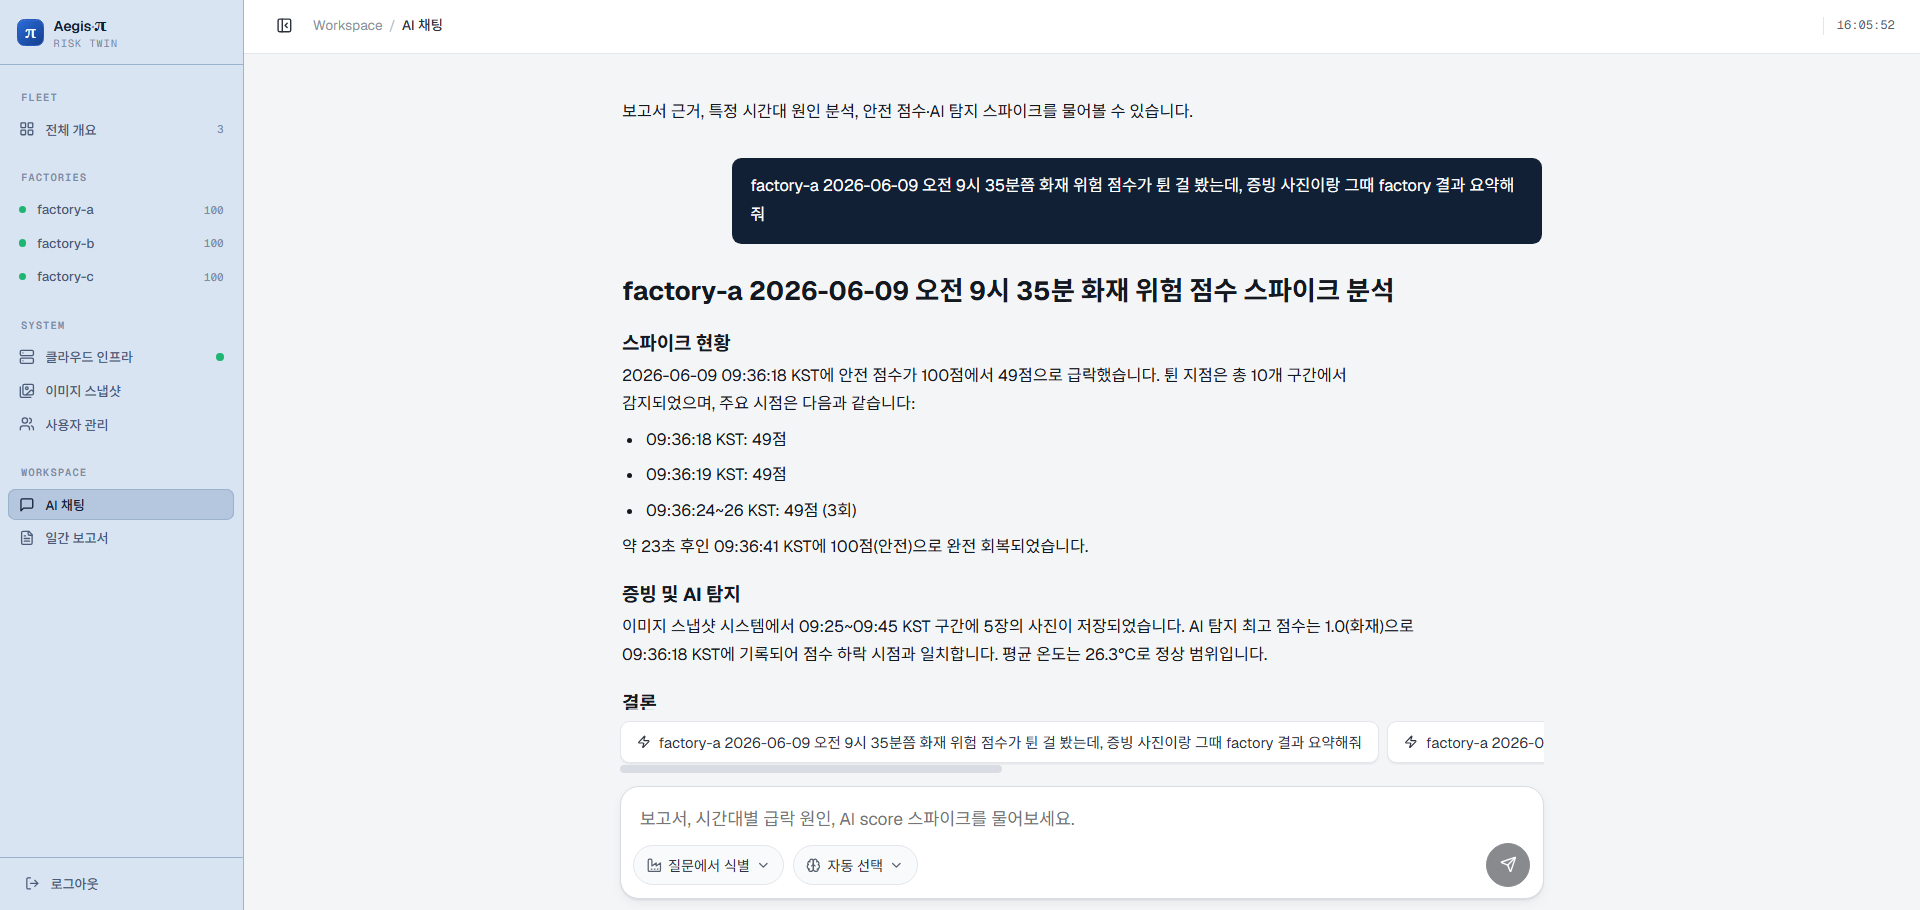
공장별 안전 점수, 클라우드 인프라 상태, AI 위험 요약 화면과 팀 최종 발표자료 중 제가 맡은 슬라이드입니다.
직접 확인하기
아래 링크에서 코드, 설계 문서, 실행 기록을 직접 확인할 수 있습니다.
범위와 한계: 교육 과정의 테스트 환경(Raspberry Pi 1대, VM 2대)에서 진행했습니다. 장애 당시 3공장 24시간 동시 조회가 DynamoDB 조회 50번 이상으로 늘어 동시 조회 한도 10을 채웠고(팀 장애 기록 #42), 바꾼 뒤 24시간 조회는 공장당 288건만 읽습니다(3초 원본이면 28,800건, 설계 기준 계산). 회귀 테스트로 기능은 확인했지만 응답 시간은 재지 않았습니다.
GitHub 개인 구현 저장소 (dashboard_vpc) ↗
데이터/대시보드 Terraform, Redis 알림, FastAPI, React 코드
문서 조회 구조 설계 기록 (ADR 0025) ↗
504 원인과 조회 기간별 읽기 방식을 정리한 설계 문서
문서 역할 분담 문서 (ADR 0005) ↗
제어 영역(팀원)과 데이터, 대시보드 영역(본인)을 나눈 기준
문서 이력 조회 API 명세 ↗
조회 기간별 데이터 출처와 응답 형식
GitHub 팀 GitHub 저장소 ↗
팀 통합 코드와 매일 회의 기록
문서 프로젝트 Wiki ↗
아키텍처와 설계 결정, 운영 문서
문서 검증 기록
포트폴리오 문구와 코드와 테스트를 대조한 기록
이미지 전체 아키텍처 원본
현장, 데이터 파이프라인, 대시보드, 관리 영역 전체 구성
PDF 최종 발표자료 PDF
MSP 최종 프로젝트 발표자료
이미지 최우수팀 상장
팀명 일터방패 | 2026.06.29