Celery 대신 Kubernetes Job을 고른 이유
이미 쓰고 있는 Kubernetes에서 요청마다 Pod를 따로 띄울 수 있어 메시지 브로커를 따로 운영하지 않아도 됐습니다. 성공 결과를 조회하면 웹이 Job 삭제를 요청하고, 실패한 Job은 로그를 볼 수 있게 24시간 남긴 뒤 TTL로 정리합니다. 대신 Pod가 뜨는 시간이 걸리고, 우선순위 제어는 직접 만들어야 합니다.
설계와 검증 근거 보기 ↗Kubernetes 실행 | 개인 프로젝트 | 단독 설계와 구현 | 2026.02.02 - 2026.03.12
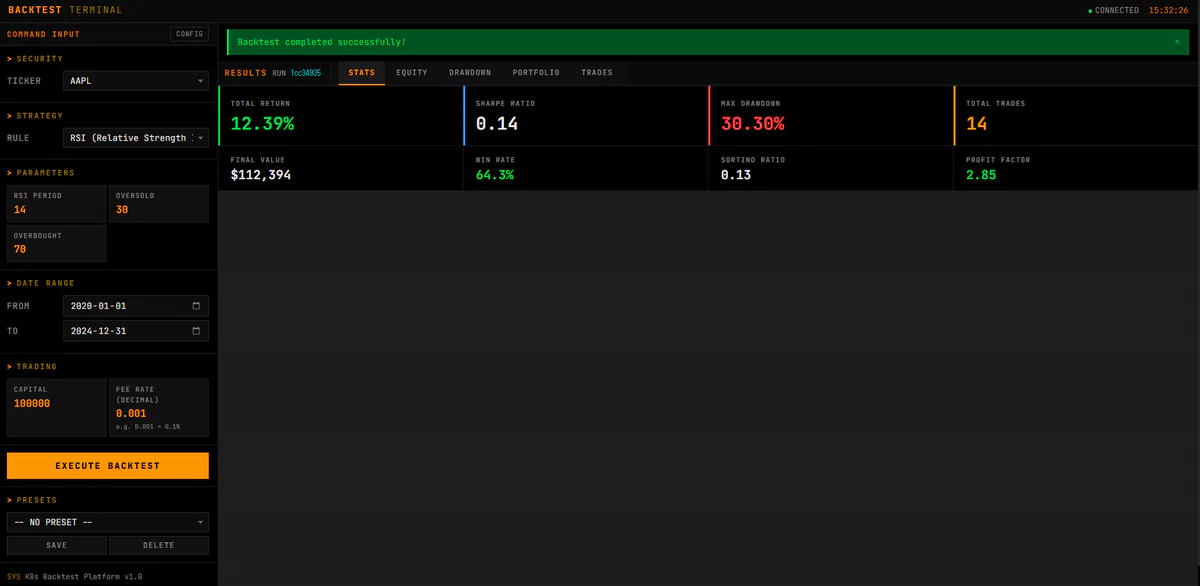
백테스트 1건을 Kubernetes Job 1개로 실행하는 플랫폼
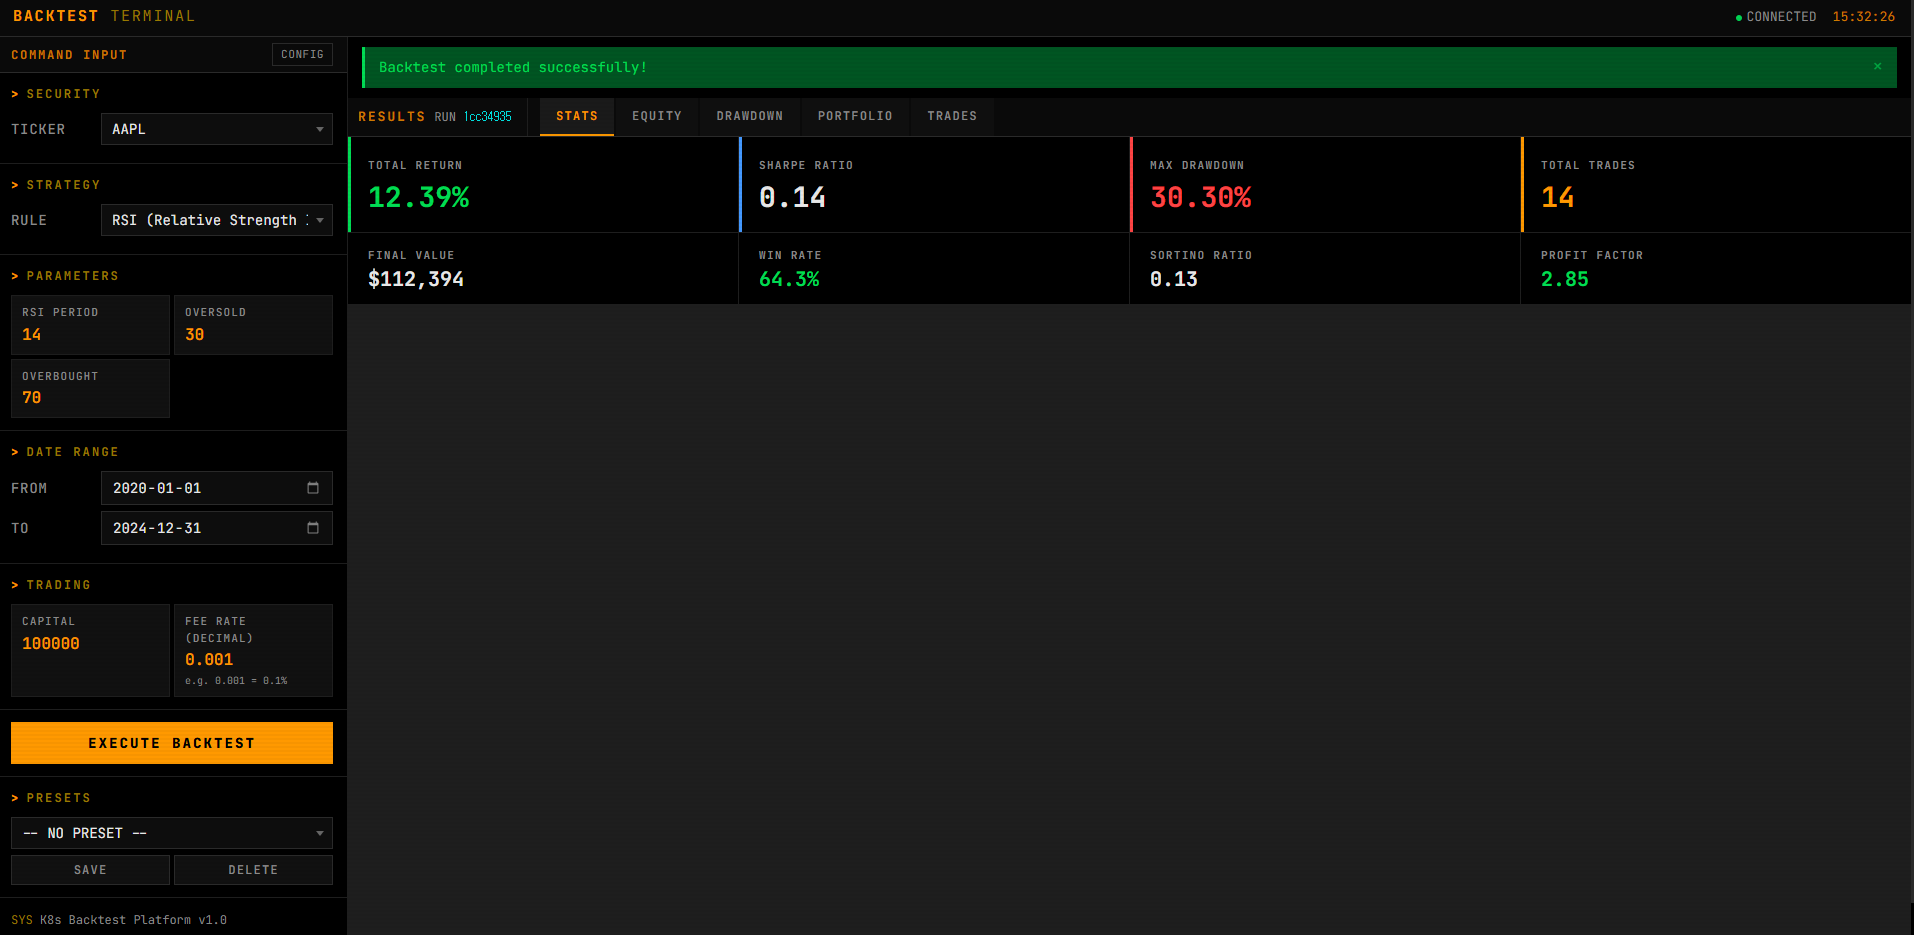
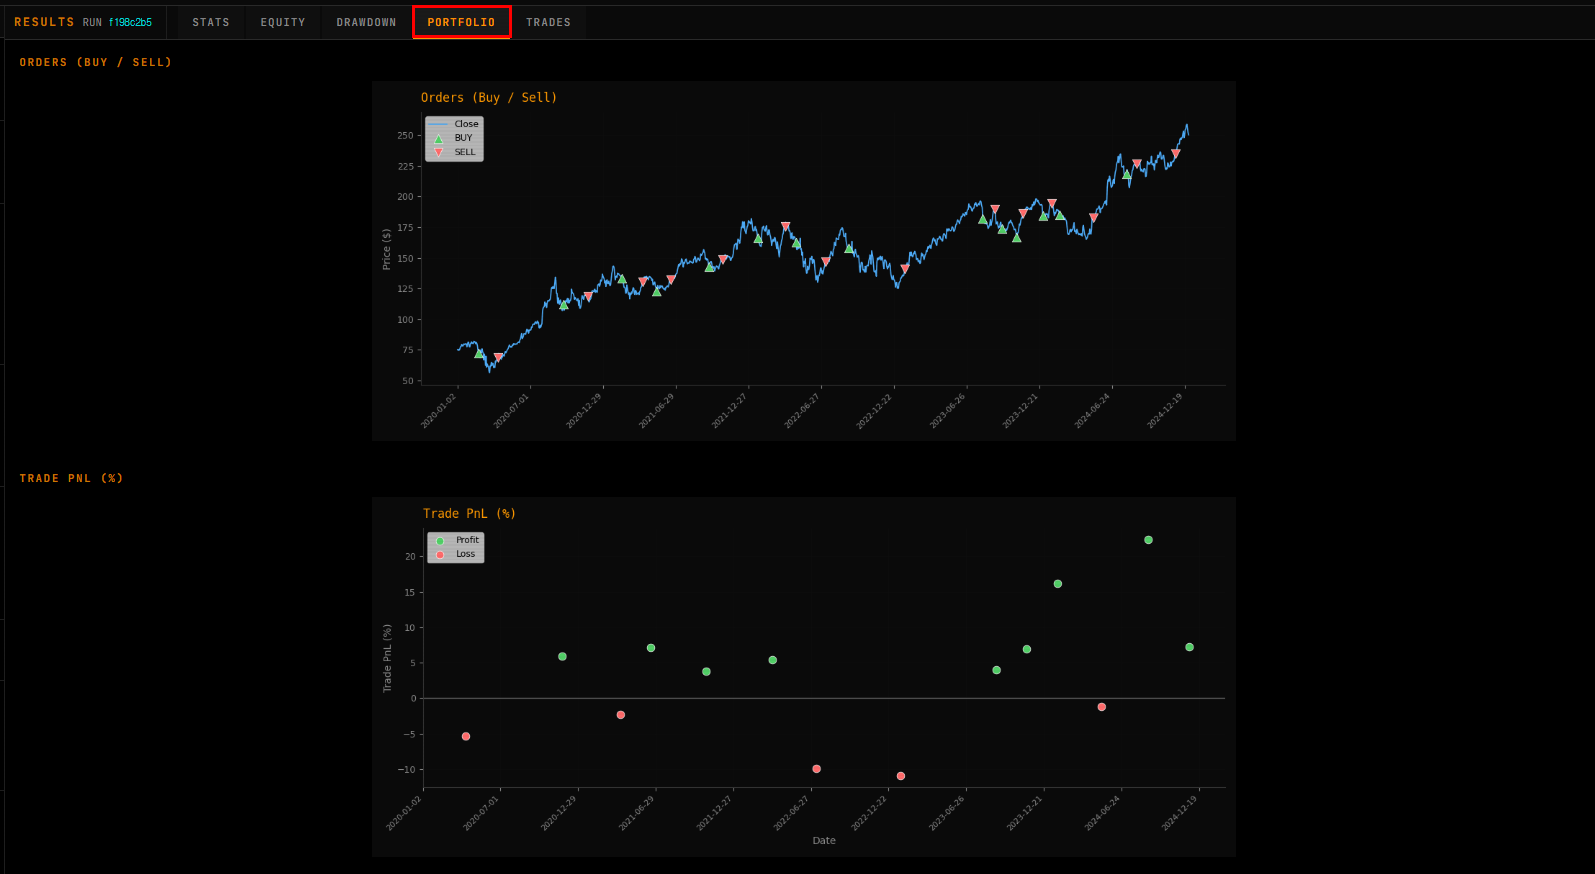
오래 걸리는 백테스트 계산을 Kubernetes Job으로 분리하고, run_id 하나로 요청부터 결과까지 추적했습니다.
실행 단위
1 Job
백테스트 1건 = Kubernetes Job 1개
추적 키
run_id
웹, Worker 로그와 MySQL 결과 연결
부하 측정
+58%
동시 요청 20건 처리량 (로컬 측정 뒤 설정 조정)
실행 흐름
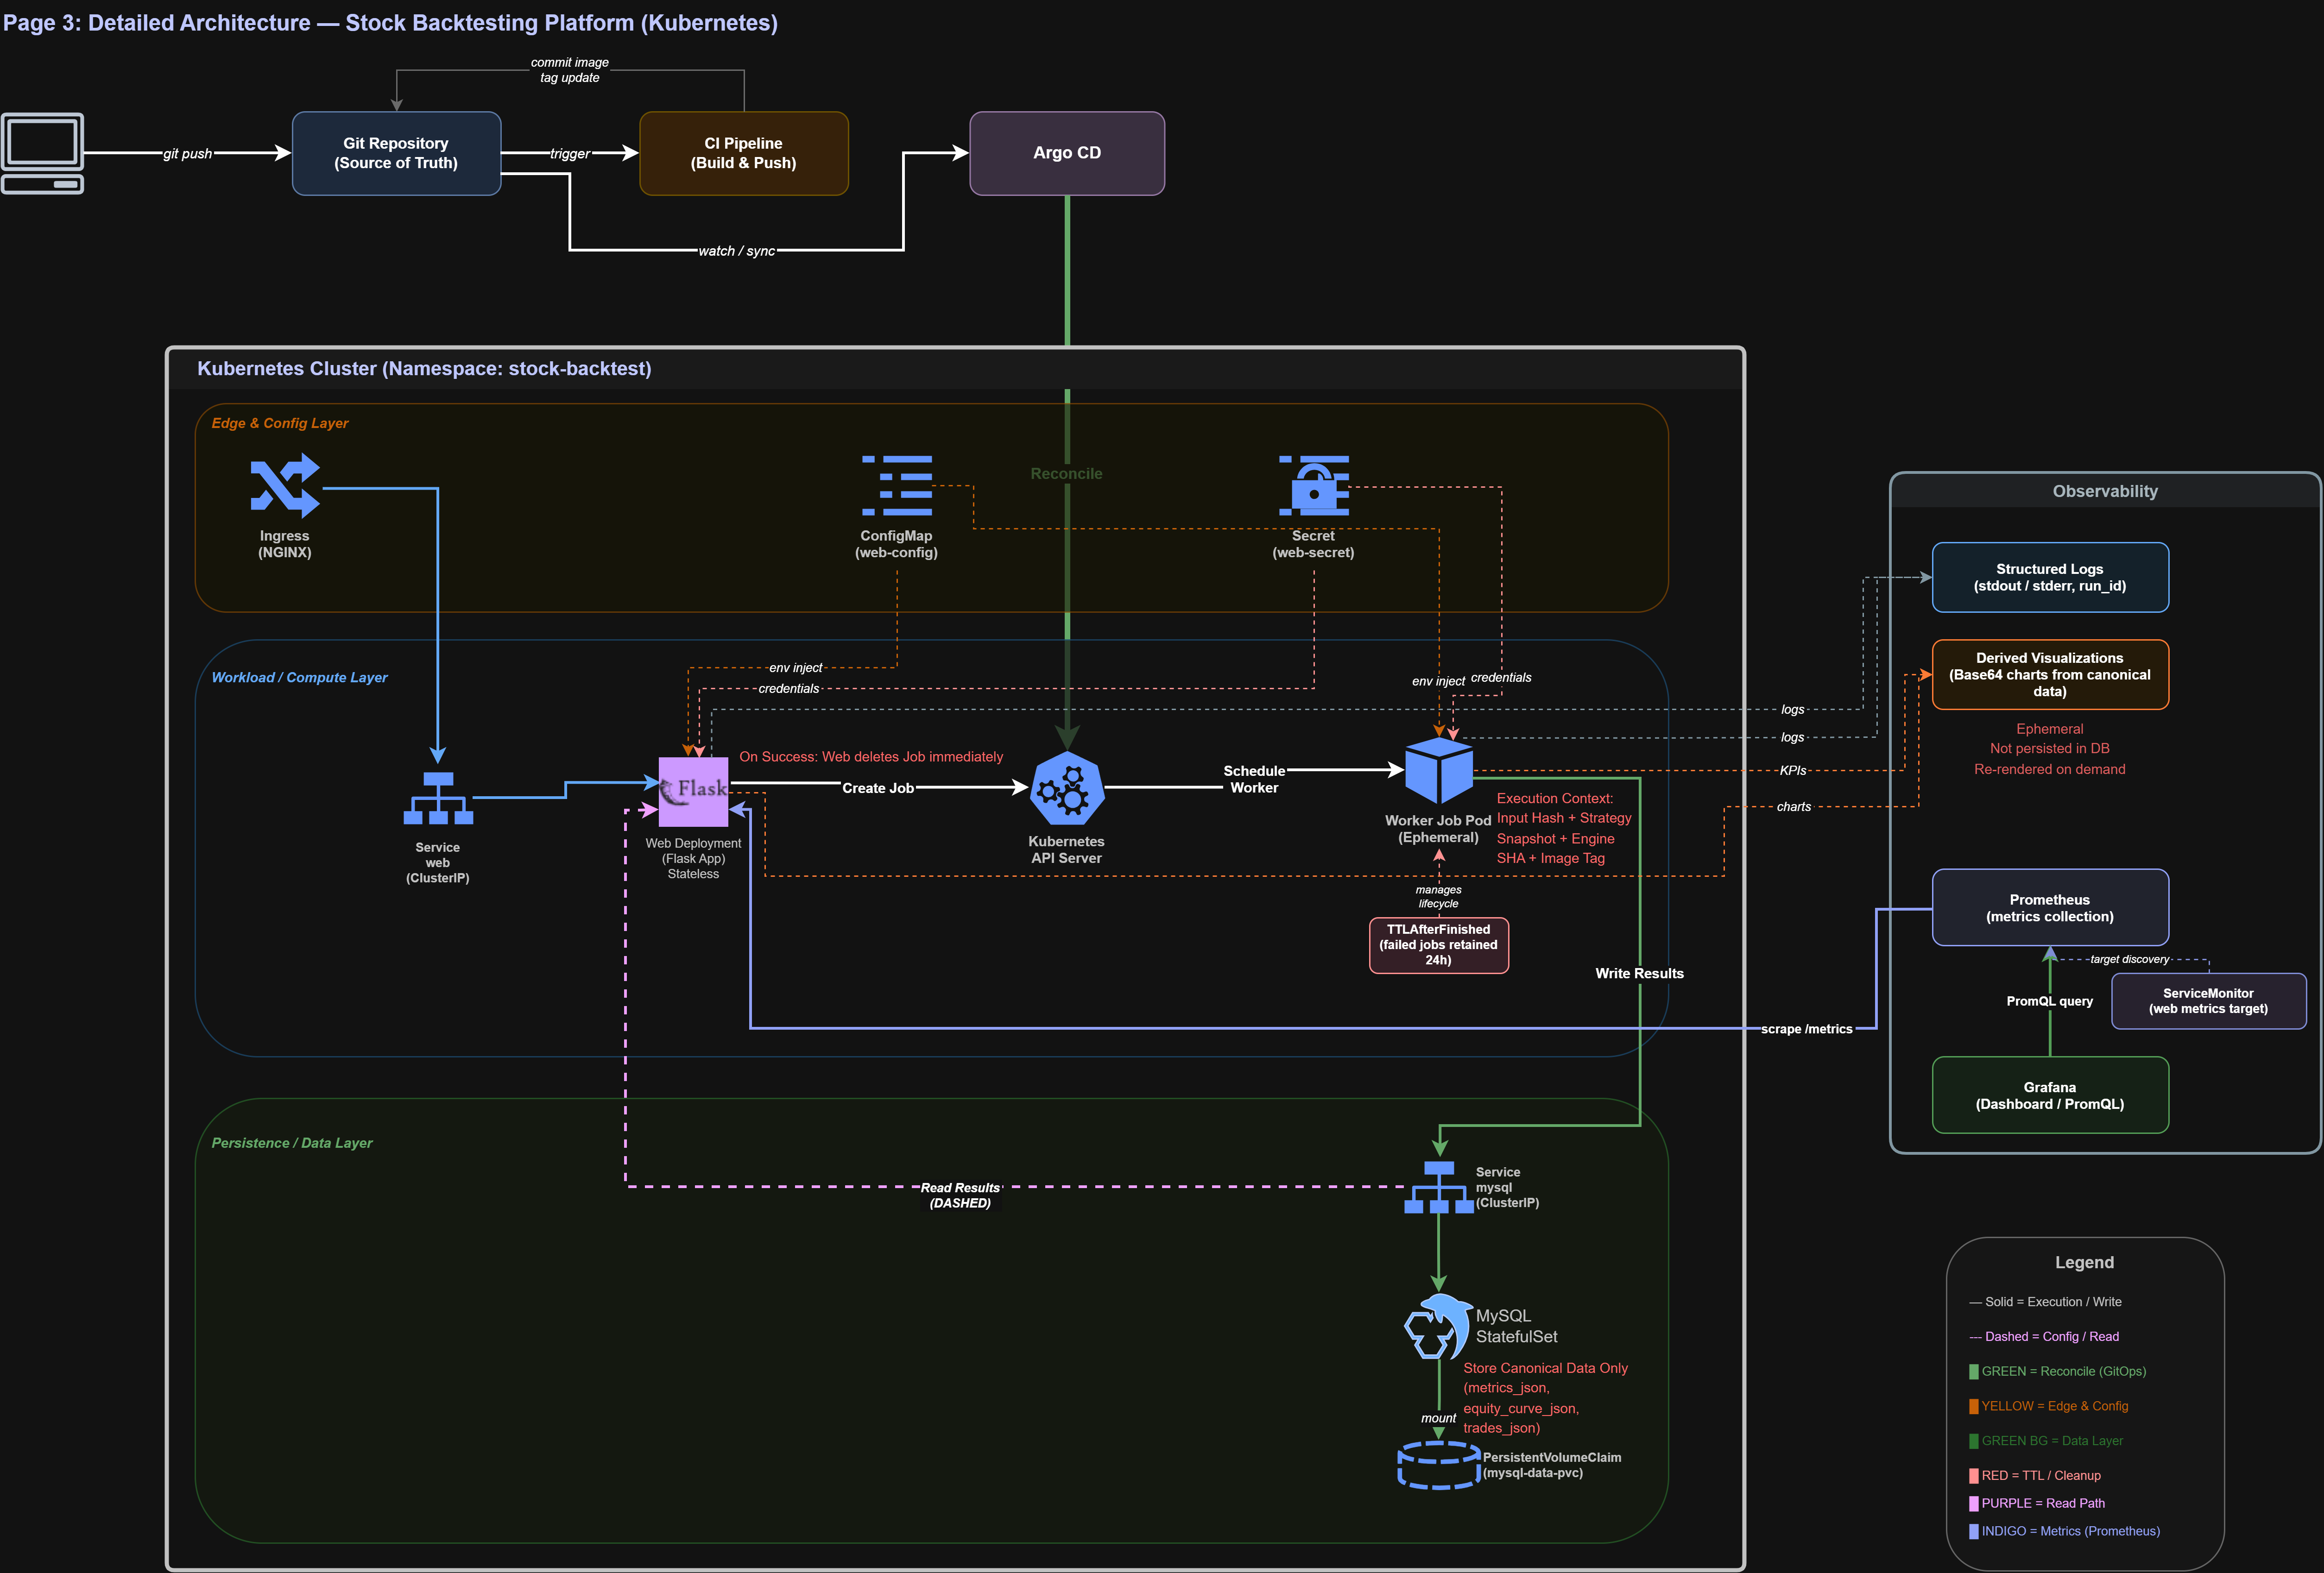
웹은 요청과 조회만 맡고, 계산, 상태 저장과 모니터링은 각각 다른 곳이 맡습니다.
요청
Flask Web
요청 접수와 상태 조회
계산
Kubernetes Job
요청마다 Job을 만들어 계산
상태
MySQL
대기 → 실행 → 완료 상태와 결과 저장
모니터링
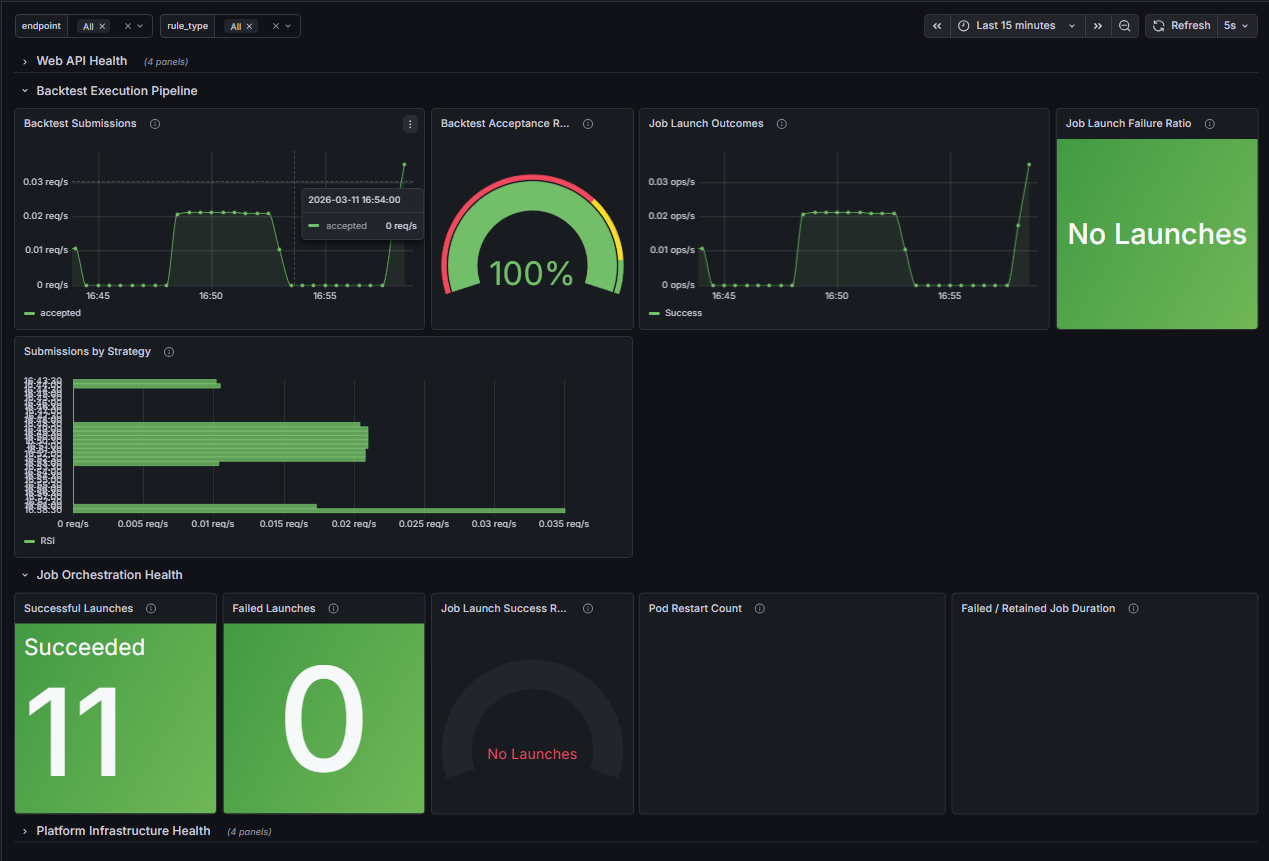
Grafana
Job 실행 수와 요청 빈도
설계 배경
오래 걸리는 백테스트 계산이 웹 요청 처리를 붙잡고 있었습니다. 계산을 웹 밖으로 빼고, 실행마다 상태와 결과를 따라갈 수 있는 구조가 필요했습니다.
실행 구조
웹, Worker Job, DB, Grafana를 run_id 하나로 잇는 실행 구조입니다.
판단 과정
이미 쓰고 있는 Kubernetes에서 요청마다 Pod를 따로 띄울 수 있어 메시지 브로커를 따로 운영하지 않아도 됐습니다. 성공 결과를 조회하면 웹이 Job 삭제를 요청하고, 실패한 Job은 로그를 볼 수 있게 24시간 남긴 뒤 TTL로 정리합니다. 대신 Pod가 뜨는 시간이 걸리고, 우선순위 제어는 직접 만들어야 합니다.
설계와 검증 근거 보기 ↗개발에 AI 코딩 도구를 썼지만, 엔진 수정 금지, API 형식 유지, run_id 로깅, 이미지 태그 고정 같은 규칙 10가지를 CLAUDE.md에 적고, AGENTS.md에는 작업을 멈춰야 하는 조건을 정해 두었습니다. AI가 만든 변경은 테스트 83개를 CI(pytest)로 돌려 확인한 뒤 반영했습니다.
설계와 검증 근거 보기 ↗로컬 kind 클러스터에 저장소 매니페스트를 올리고 요청을 20건 동시에 보냈습니다. 계산 Job은 1초 안팎이었지만, 결과 조회가 조회마다 차트를 다시 그려 한 건에 1.6~1.9초씩 웹 워커 1개를 붙잡았습니다. 웹 워커를 3개로 늘리자 메모리 한도 512Mi를 넘어 OOMKilled로 6번 재시작했고, 웹 워커 2개, CPU 한도 1코어, 메모리 한도 1Gi 구성에서 처리량이 분당 27.7건에서 43.7건(+58%)으로 늘어, 이 구성을 매니페스트에 반영했습니다(PR #4). 조회마다 차트를 다시 그리지 않게 바꾸는 것이 다음 과제입니다.
설계와 검증 근거 보기 ↗2026-03-04 요청 한 건을 처음부터 끝까지 실행해, 같은 run_id로 대기 → 실행 → 완료 상태와 MySQL 저장을 확인했습니다. Job 생성에 실패하면 요청이 대기 상태에 남지 않고 실패로 바뀌는지도 테스트했습니다.
설계와 검증 근거 보기 ↗핵심 코드
요청의 run_id를 Job 이름과 라벨에 넣어, 로그와 결과를 같은 ID로 찾을 수 있게 했습니다.
Kubernetes Job 생성 코드
launchers/job_launcher.py
metadata = client.V1ObjectMeta(
    name=build_job_name(_stringify(run_payload.get("run_id"))),
    namespace=self.namespace,
    labels={
        "app": "worker",
        "run_id": _stringify(run_payload.get("run_id")),
    },
)

container = client.V1Container(
    name="worker",
    image=self.worker_image,
    image_pull_policy="IfNotPresent",
    command=["python", "worker.py"],
    env=env,
    env_from=[
        client.V1EnvFromSource(
            config_map_ref=client.V1ConfigMapEnvSource(name=self.configmap_name)
        ),
        client.V1EnvFromSource(
            secret_ref=client.V1SecretEnvSource(name=self.secret_name)
        ),
    ],
)
직접 확인하기
아래 링크에서 코드, 설계 문서, 실행 기록을 직접 확인할 수 있습니다.
범위와 한계: 동시 요청 처리량은 로컬 kind 클러스터 1노드에서 한 번씩 잰 값이며 운영 수치가 아닙니다. 가장 나았던 구성(웹 워커 2개, CPU 1코어, 메모리 1Gi)은 저장소 매니페스트에 반영했고, Worker가 중간에 멈춘 모든 경우의 복구는 아직 검증하지 않았습니다.
GitHub GitHub 저장소 ↗
웹, Worker, Kubernetes 매니페스트, CI 전체 코드
문서 요청 한 건 실행 기록 ↗
같은 run_id로 상태 전이와 결과 저장을 따라간 기록
코드 Worker Job 템플릿 ↗
재시도 횟수와 완료 후 자동 삭제(TTL) 설정
코드 지표 수집 설정 (ServiceMonitor) ↗
Prometheus가 웹 지표를 가져가는 설정
문서 AI 작업 규칙 (CLAUDE.md) ↗
엔진 수정 금지, API 형식 유지, run_id 로깅 등 규칙 10가지
문서 AI 에이전트 작업 지침 (AGENTS.md) ↗
작업 전 확인 목록과 작업을 멈춰야 하는 조건
문서 로컬 부하 측정 기록 ↗
동시 요청 20건, 구성 4가지 비교와 원자료(JSON)
코드 CI 워크플로 ↗
push와 PR마다 pytest 실행, 이미지 빌드
문서 수상 기록 ↗
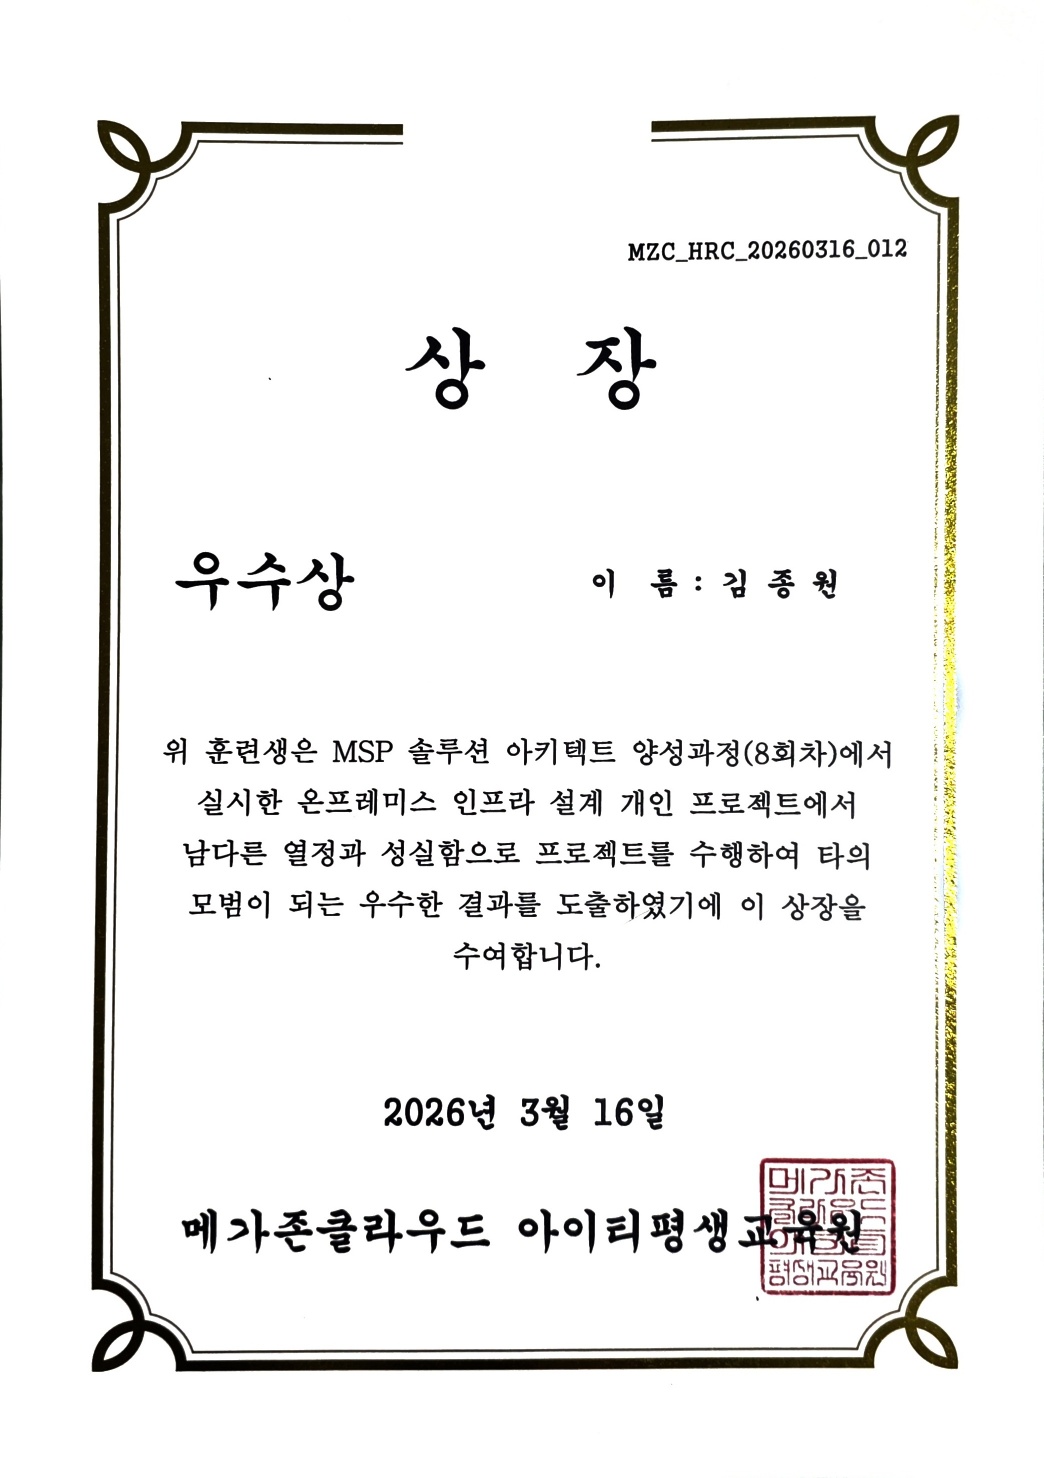
MSP 과정 개인 프로젝트 우수상 기록
PDF 최종 발표자료 PDF
MSP 과정 개인 프로젝트 발표자료
문서 최종 아키텍처 Wiki ↗
웹, Worker Job, MySQL, GitOps, 모니터링을 포함한 최종 구조